LocalNetHealth
A quieter perspective on your network.
つながらない、その前後を見えるように。ローカルネットワークの状態を観察し、不調の手がかりを残すWindows向けツール。
DETAILSSIMPLE TOOLS.
DEEPER UNDERSTANDING.
Listen to the unspoken.
LESS FRICTION.A quieter perspective on your network.
つながらない、その前後を見えるように。ローカルネットワークの状態を観察し、不調の手がかりを残すWindows向けツール。
DETAILSSIMPLE TOOLS.
DEEPER UNDERSTANDING.
AI Agent運用で行った検証を、仮説・方法・観測・判断の順に記録します。
全体構成ではなく、確認できた断片だけを残します。
日々の作業に、小さな道具を。
個人で制作したツールを、ここから公開していきます。
個人制作のツールと、技術の実験を集める場所。
作業の途中で感じる小さな不便や、見えないままになっている問題。そうしたところから出発して、日々使える道具の形にしていきます。
まず観察する。小さく試す。実際に使い、直す。完成したものだけでなく、その判断や試行もここに残します。
Tailscale v1.104.4が公開された。Tailwormと呼ばれる調査報告に関連し、Tailscale SSHとServeのセキュリティ問題に対する修正が含まれている。公式のセキュリティ情報では、TS-2026-014〜017についてv1.104.4以降で修正済みと案内されている。v1.104.4リリース・開発元の説明
SSHの権限処理:Unixソケット転送を、管理者権限のrootではなく、認証された利用者の権限で実行するように変更。許可されたSSH接続から、本来触れない管理用ソケットに届いてしまう問題への対策だ。TS-2026-014
SSHのメモリ使用量:セッションで使えるメモリに上限を設け、切断時に解放するように修正。認証済みの接続によってメモリを使い尽くし、Tailscaleの通信を止める問題に対処した。TS-2026-015
Serveの接続先検証:Tailscaleの管理用ソケットへの転送を制限し、接続のたびにバックエンドを再確認するように変更。設定後の接続先のすり替えなどにより、権限の強いソケットへアクセスできる問題に対処した。TS-2026-016
Serveの権限情報:権限情報をリクエストごとに分離。HTTP/2で複数の処理を同時に流したとき、別のサービス向けの権限情報が混ざり、誤ったアクセス許可につながる問題を修正した。TS-2026-017
DERP中継への接続処理:Tailscaleクライアントが、接続成立を示す応答以外の本文を読む量にも上限を追加。悪意ある中継先から大量のデータを返されたときのメモリ枯渇への対策で、v1.104.4に含まれている。これはHeadscale全体の問題が解消されたという意味ではない。公式の修正コミット
対象範囲:主なSSHの問題は、認証され、ポリシーで許可された接続後の権限や処理に関するものだ。外部の誰でも未認証で任意の端末へ接続できる、という説明ではない。また、製品機能のTailscale SSHと、Tailscaleの通信経路上で通常のOpenSSHを使う構成は区別する。開発元の説明
ただし、「Tailwormで指摘されたすべてが完全に修正された」とはまとめない。開発中のConn25への指摘について、開発元は未リリース機能に関するもので、安定版のApp Connectorには影響しないと説明している。今回の安定版での修正内容と、開発中機能の対応状況は別に扱う。開発元の説明
対象機能を利用している場合は、公式案内に沿ってv1.104.4以降への更新と、実際に適用されたバージョンを確認したい。自動更新を有効にしていることと、修正版が端末へ届いたことは別だ。影響条件は機能や設定ごとに異なるため、公式の対象説明と照合する。公式セキュリティ情報
更新履歴:2026年10月28日、修正版の公開と主な対策内容を追記。同日、修正内容・対象範囲・出典を記事の冒頭に集約した。以下は元の記事と当時の経緯。既存本文・読みものにある10月25日・26日の記述は、当時の確認内容として保持している。最新の修正状況はこの追記を参照。
別々の場所で動くAIエージェントが、必要なときに同じ作業環境へアクセスできれば、調査、実装、確認を分担しやすくなるのではないか。MuseからCodexを使っているWindows環境へ接続する実験を、その足場として進めている。
Tailscaleでプライベートな通信経路を用意し、その先のWindows OpenSSH Serverへ公開鍵でログインする構成だ。ここで使うSSHは、Tailscaleのネットワーク上で動く通常のOpenSSHで、製品機能としての「Tailscale SSH」とは区別している。
Tailscaleへの参加とOpenSSH Serverの導入に続き、SSHの受け口をTailscale側に限定し、ファイアウォールで接続元を絞る設定と公開鍵の登録まで進んだ。Windows側のサービスが稼働し、自動起動に設定されていることも管理者から報告を受けている。
2026年10月25日の追記として、Muse側で接続先のホスト鍵を照合し、公開鍵認証でログインできたとの本人報告を受けた。先に公開した時点では初回接続前だったが、現在は接続経路の確認まで進んだ段階として記録する。接続先を識別する値や鍵そのものは掲載しない。
Tailscaleは、離れた端末間に暗号化された仮想ネットワークをつくる。同じ物理LANへまとめる仕組みではなく、接続先のサービスや認証も別に必要になる。
この経路とSSHを組み合わせれば、別々の環境にいるAIが、許可された共通の作業場所へアクセスする構成を考えられる。たとえば、一方が用意した調査結果をもう一方が参照し、実装や確認を引き継ぐ流れだ。これは今回の接続から考えた使い道であり、協業全体を実証した結果ではない。
2026年10月26日時点で、Tailscale SSHなどに関する脆弱性の報告が出ている。開発元は、主に許可されたSSH接続後の権限や転送処理に問題を確認しており、影響する設定の範囲は調査中としている。また、通常のOpenSSHをTailscaleのネットワーク越しに使う構成と、製品機能のTailscale SSHは別だと説明している。この記事で扱うのは前者であり、今回の主なSSHの問題とは区別できる。開発元の説明
ただし、研究者の報告はSSH以外の機能も含む。Tailscale SSHを使っていないことだけで、報告全体の影響がないとは判断しない。また、接続できたことを確認する試験と、利用環境全体の安全性を調べることも別に扱う。今回の記事は、すべての追加機能や設定を検査した結果ではない。研究者の報告
公開されている公式説明で、Tailscale SSHと通常のSSHの違いを確認した。Tailscale SSHは、TailscaleがSSH接続の認証やアクセス許可を管理する追加機能だ。Tailscaleを通信経路にして、別に動かした通常のOpenSSHへ接続する使い方とは異なる。「Tailscale経由でSSHを使っている」というだけでは、どちらかは決まらない。まず、自分の端末でどの機能を有効にしているかを確かめたい。Tailscale SSHの公式説明
影響の有無は、問題ごとの条件と利用している機能によって異なる。Tailscale SSHやServeを使っていないことは、それぞれの機能に依存する問題を切り分ける材料になる。ただし、研究者の報告にはDERPという中継機構を使うクライアントへの指摘もある。悪意ある中継先へ接続させられる条件でのメモリ枯渇という報告であり、通常の接続だけで必ず被害が起きるという意味でも、SSHを無効にすればすべて無関係になるという意味でもない。研究者の報告
利用中のバージョン、公式のセキュリティ情報、変更履歴を照合し、自分が使う機能への対処が案内されているか確認する。自動更新の設定が有効であることと、必要な修正版が公開され、端末へ適用されたことは別だ。確認できていない端末や設定まで「安全」と広げず、未確認として残しておきたい。この記事は一般向けの整理であり、個々の利用環境の安全性を保証するものではない。
Tailscaleが担うのは通信の土台まで。仕事の受け渡しや順番、実行を止める判断は、別に設計する必要がある。誰からの依頼かを識別すること、各AIが触れてよい範囲、依頼と返答の形式、同じ仕事の重複実行を防ぐ方法、結果を追える記録がまだ必要だ。
GrokBotも加える案はあるが、現在は読み取り専用での事前確認の段階で、接続や協業ができたとはしていない。複数のAIが自律的に仕事を分担し、最後まで完了できることも未検証だ。
まずは、許可した小さな作業を一つだけ受け渡す。依頼を識別する番号、担当、操作範囲、完了条件を先に決め、受け取った結果と実際の状態を照合する。接続できたAIへ無制限に操作を任せず、公開や権限変更などは人間の承認を残す。
共通の作業環境を使う場合は、同時編集や上書きも避けたい。通信できるところから、一つの仕事を安全に引き継げるところまで、段階を分けて確かめていく。
セラフィムの動く絵文字に、骨董店の空気感を加えたい。キャラクターは大きく変えず、背景、ピンクの文字、店主の衣装を整える制作を進めている。
暖かな店内を背景にしつつ、細かな点状のテクスチャは抑える。背景の外周を透過し、ピンクの文字と店主の衣装を整えた。つま先には、ほのかに猫の足を感じる形を取り入れている。
LINEのアニメーション絵文字は180×180ピクセルのAPNGで、背景透過が必要。大きな絵として好ましい見た目と、小さな絵文字として読めることは別に確認しなければならない。 今回は24点をAPNGにし、全点が180×180ピクセル・300KB以内であることを確認した。ただし、形式の検証に通ることと、絵として完成していることは別だ。
縮小時の文字や表情、フレーム間の形の揺れを目視で確認する。生成由来の揺れについては、まだ最終確認が残っている。静止した最初の一枚でも意味が伝わることを優先したい。現在はLINEの審査申請に向けた準備中で、未申請・未販売。
大きな利用枠があるなら、調査や下書きの一部をMuseに任せ、ほかのAIへの支出を減らせるだろうか。「10億トークン」という量ではなく、必要な仕事を終えられるかを確かめたい。
MetaのMuseは、モデルやツール、会話の文脈、入力と出力によってトークンの消費量が変わる。公式ヘルプでは購入追加分とプロモーショントークンは失効せず、Muse内だけで使うと説明されている。これはChatGPTやCodexのトークンと単純換算できる共通通貨ではない。
「10億トークン」はMeta Museの紹介特典に関するものとして調べている。ただし、本人への付与、対象モデル、利用条件は未照合。紹介告知の公式投稿本文は確認できず、10億の枠が上記の失効しない対象かも確定していない。実際に節約できたという結果はまだない。
アプリ内の案内を確認したうえで、同じ小さな調査課題を比較する。成果の正確さ、修正回数、待ち時間、人間の確認時間と支払いの変化を記録したい。大きな枠があることと、必要な仕事を安く終えられることは分けて評価する。
自宅PCを常時起動せず、必要なときだけ外出先からスリープ解除して使いたい。まず宅内での起動と、その後の遠隔操作を分けて試した。
宅内ではルーターから起動操作を行い、Chrome Remote Desktopへ接続できた。ただし、遠隔画面が開いたという結果だけでは、PCが確実にスリープしていたことや、接続操作自体が起こしたことまでは証明できない。
外部回線からのVPN接続は、証明書の署名に関するエラーで止まっている。ルーターには空き容量不足のログもあり、更新を試した後も旧ファームウェアのままだった。これらの因果関係は未確定で、初期化や更新の繰り返しは止めている。
現在の設定を保全したうえで障害を切り分ける。VPN接続、宅内への到達、スリープ解除、遠隔画面への接続を順番に確認する。宅内の成功を、そのまま外出先でも使える手順としては扱わない。
ログインのたびにパスワードを探す手間を減らしながら、端末を失った場合にも困らない管理方法を考える。1Passwordについて、まず公式の機能と復旧に関わる情報を確認した。
ブラウザー版ではログイン情報の保存・入力、パスワードの生成、対応サイトのパスキー管理ができる。一方、Secret Keyはアカウントパスワードと組み合わせて情報を保護するもので、パスワードを忘れたときの単純なバックアップコードではない。
自分の利用環境で入力の手間がどれだけ減るか、既存の保存先から無理なく移行できるかは未評価。導入だけで安全性が保証されるわけではない。
日常の少数のログインで使い勝手を確認し、Emergency Kitの保管も別に整理する。操作をAIに手伝ってもらう場合も、秘密情報そのものを会話や作業記録に残さない境界を保つ。
前回は、GitHubのコメントをきっかけにAIが動き、依頼と返答を残すところまで試した。今回はその続き。こちらから頼むだけでなく、相手からの依頼も受け取り、ひとつのやり取りを終える実験をした。
最初のお題は2+3と7+8。AIに解いてもらうには簡単すぎるけれど、確認したいのは計算能力ではない。どの依頼への返答なのか、逆方向の依頼をどう受け取るのか、どこで終わりにするのか。その流れを確かめるには、答えが明白な問題がちょうどいい。
実際に5という結果を受け取り、逆方向に頼まれた7+8には15を返した。返した答えが元の依頼と一致することを確認して、この往復は終了。返事にまた返事を重ねるのではなく、ちゃんと終われるところまで含めた小さなテストになった。
その後は、公開情報を調べたり、役割分担や評価方法を相談したりするやり取りへ進んだ。GitHubは依頼や結果の記録場所として使っている。相談の返答が届くことと、その提案を実装してよいことは、ここでも分けている。
仕事らしい内容になると、今度は「何をもって完了にするか」が気になってくる。
計算なら答えを照合すればよい。でも調査や設計相談では、返答が届いたこと、内容が正しいこと、頼んだ範囲を守ったことをそれぞれ確かめる必要がある。返答に「成功」と書いてあっても、それだけでは合格にできない。
そこで、依頼する前に完成条件を少数に絞って書く案を相談した。たとえば、参照した一次資料を示すこと、確認できた事実と未確認の点を分けること。終わったら、各条件を満たしたか、未達なのか、判断材料が足りないのかを根拠とともに返す。人に仕事を渡すときのチェックリストに近い。
失敗から得た気づきも、すぐ次のルールにしてしまわない。まずは改善案として残し、必要な変更かを確認する。AI同士で話がまとまったことと、人間がその変更を承認したことを混ぜないためだ。
完成条件を使った評価はまだ相談と設計の段階だ。時間や確認の手間がどれだけ減るかも測れていない。今回確かめられたのは、小さな依頼を往復させて終えられたことと、調査・設計の相談を記録に残せたことまで。
毎回の起動や、重複処理が絶対に起きないことを保証するものでもない。
つながった先で、何を頼み、何を確かめて受け取るか。AI同士の協業を試しているつもりが、仕事の渡し方を見直す実験にもなってきた。
今回は、クラウド上に作業用のパソコンを持つChatGPT DotsとGrok Botの連絡を試している。「二人の相談相手」よりも、「それぞれ作業机とパソコンを使う担当者」と考えると近い。文章で助言するだけでなく、ファイルを作ったり、ブラウザーを使って確かめたりする仕事につなげたい。今回の取りまとめ役はDots、協力相手はGrok Bot。GitHubは、依頼と結果を書いておく共有ノートのような場所だ。
ノートに新しい依頼が書かれたら、相手に「仕事が来たよ」と知らせたい。この通知が、家のドアベルに当たる。今回、GitHub Actionsが依頼の到着をきっかけに送信処理を動かし、Grok Botが課題に答え、その結果を確かめるところまで試せた。課題はC、A、BをA、B、Cに並べるという簡単なものだった。
受け取る側のドアベルも、別の単発試験で確認した。GitHubのプルリクエストに付いたテストコメントの通知が、人間が新しく話しかけなくても、既存のChatGPT Dotsの会話に届いた。ただし、これはGrok Botの本当の回答で一連の仕事が自動再開した試験ではない。試験用の受信は終了しており、常時動く仕組みも有効にしていない。
たとえば将来、Dotsが画面の要件と試作品をまとめ、Grok Botが自分の作業環境のブラウザーで動かして確かめ、スクリーンショットと再現手順を返す。Dotsはその結果を受けて修正内容を整理する。やり取りするのは「良さそう」という感想だけでなく、次の作業で実際に使える成果物だ。これは今後試したい例で、今回こうしたファイルの受け渡しまで実証したわけではない。
必要な作業がクラウド内で完結するなら、人間が両方の会話画面を開き続け、毎回文章やファイルを運ぶ役にならずに済む可能性がある。完了のドアベルで次の担当者が動ければ、スマートフォンで目的を伝え、途中の重要な判断と仕上がった成果物を確認する使い方も考えられる。ただし手元のパソコンにしかないファイルや作業には、その環境へのアクセスが必要だ。時間や費用の削減を測れたわけでもない。
ドアベルが鳴ることと、届いた内容を信用して実行してよいことも別だ。誰からの連絡か、どの依頼への返事か、同じ仕事を二度しないかを確かめ、答えの品質と操作の範囲を確認する必要がある。AIが自分で権限を決める仕組みや、本番の仕事をすべて自律的に進める仕組みが完成した、という話ではない。
2026年10月16日(日本時間)時点の実験記録。複数のAIの作業を取りまとめる「オーケストレーター」が、別のAIへ範囲を限った依頼を送り、その結果を受け取って確かめる流れを試した。
今回の取りまとめ側はChatGPT Dots、協働するエージェントはGrok Bot。依頼と回答を受け渡す場所にはGitHubを使い、依頼コメントの到着をきっかけに送信処理を動かす役割をGitHub Actionsが担った。
これは複数のツールを組み合わせた実験であり、ChatGPT DotsとGrok Botが公式機能で直接つながる連携を紹介するものではない。
最初の課題は、C、A、BをA、B、Cの順に並べること。ChatGPT Dots側で依頼を作り、Grok Botを自動で起動し、課題への回答を受け取り、その回答が元の依頼に対応していて正しいことを確認できた。
並べ替え自体はごく簡単だが、今回の焦点は難しい問題を解けるかではない。人間が依頼文と回答を運ばなくても、限定した一往復を成立させられるかを確かめた。
まず手動で起動する試験を行い、その後、GitHubの依頼コメントをきっかけにGitHub Actionsの送信処理が動く試験でも成功した。コメントをきっかけにした送信側の試験では、人間が実行ボタンを押す工程はなかった。
回答コメントも起動のきっかけになり得るため、返信によって始まった実行では送信処理をスキップした。今回の試験では、回答が次の回答を呼び続けるループは起きなかった。
いずれも一回の依頼を扱う小規模な実験である。常時稼働する本番サービスとしての安定性や、長時間・多件数での動作を確認したものではない。
依頼がGrok Botへ届き、回答がGitHubへ戻るという意味で、メッセージの往復はできている。この送信側の試験では、親側であるChatGPT Dotsが戻った回答を自分から確認・ポーリングした。ポーリングとは、新しい結果が来ていないかを繰り返し問い合わせることだ。
その後、受信側を別の単発試験で確かめた。GitHubのプルリクエストに付いたテストコメントのイベントが、新たな人間の発言なしで、既存のChatGPT Dotsの会話に届いた。受信イベントを会話へ届けることについては、この限定した条件で確認できた。
ただし、実際のGrok Botの回答をきっかけに親側が起動し、待っていた作業を再開する流れは、まだ通して検証していない。繰り返し利用したときや会話が長くなったときの動作、本番での信頼性も未確認である。試験用の一時的な受信は停止し、常時稼働する設定は有効にしていない。
確認できたのは「依頼側からGrok Botを自動で起動し、回答を受け取って検証する試験」と「別のテストイベントを既存の会話へ届ける試験」である。二つの単発成功を、双方向に自動で仕事が進む運用の完成とは扱わない。
注目しているのは、二つのAIの回答を比べることよりも、二つのクラウド上の作業環境を、成果物と完了イベントでつなぐことだ。ここからは公式資料で確認できる機能をもとに考えた将来の設計であり、今回の並べ替え試験で効果を測定したものではない。また、この二つだけに可能な機能だと主張するものでもない。
公式資料では、ChatGPTのdotは専用のクラウドコンピューターを持ち、会話の合間にも調査、コードの作成・テスト、資料作成などを進められると説明されている。Grok Botにもブラウザー、ファイル、ターミナルを使うクラウド上の作業環境がある。こうした実行環境があるからこそ、依頼を受けた側で実際に作業し、検証できる形の結果を返す設計を考えられる。公式資料:OpenAI — Getting started with your dot、Grok Bot — Overview。
受け渡すものには、コードの差分、CSV、検証ログ、スクリーンショット、成果物へのURLなどが考えられる。受信側がアクセス権のある成果物を自分の環境で開き、加工・実行・検証して返す。Grok Botの公式資料も、レビューして引き継げる成果物として文書、表計算、スライド、スクリーンショットやログを挙げている。ただし、Dotsとの間でこれらを自動受け渡しする経路は、今回まだ試していない。公式資料:Grok Bot — Files and results。
仕事がクラウド内で完結するなら、利用者のPCを中継役として動かし続けたり、両方の会話画面を開いて伝言したりする必要を減らせる可能性がある。Grok Botのクラウド作業は、アプリや手元のノートPCを閉じても続くと説明されている。一方、ローカルだけにあるファイル、手元のブラウザーでしか通れない操作、ローカルネットワーク内の作業には、その環境と必要な許可が残る。今回の実験全体がすでにPC不要になった、という意味ではない。公式資料:Grok Bot — Use the computer and apps。
次の例はいずれも今後の検証候補であり、今回の実績ではない。役割は目的に応じて選ぶ。Dotsを目的・背景の保持、段取り、最終的な取りまとめに置き、Grok Botへ範囲を決めた調査や検証を頼むのは一つの案で、モデルの性能上の優劣や固定した得意分野を示すものではない。
一つ目は、Dotsが要件と試作品を用意し、Grok Botがブラウザーで操作を確かめ、スクリーンショットと再現手順を返す流れ。Dotsは実際の表示や操作の証拠をもとに、修正案や変更の要約をまとめる。「作る担当」と「触って確かめる担当」を、それぞれの作業環境でつなぐ。
二つ目は、Grok Botが出典付きの調査結果をCSVにし、Dotsがそれをレポートやスライドへまとめる流れ。足りない列や裏付けが見つかったら、対象を絞って追加調査を返す。文章の要約だけでなく、再利用できるデータと根拠を往復させる。
三つ目は、スマートフォンから目的を伝え、クラウドで作業を進め、必要な判断と成果物を受け取る流れ。Grok Botのモバイルアプリは、デスクトップと同じBot、会話、共有クラウドコンピューターにつながると説明されている。この入口とDotsとの連携がつながれば、人間が外出先で各工程を中継する負担を減らせるかもしれない。ただし、二つのサービスをまたぐこの一連の動作は未検証である。公式資料:Grok Bot for Mobile。
成果物に加えて、「処理が終わった」というイベントを渡せれば、次の担当が待っていた作業を再開できる。結果がない間の確認を減らし、どの依頼からどの成果物ができ、何を根拠に次へ進んだのかも追いやすくなる。人間は伝言よりも、方針の選択、成果物の採否、影響の大きい操作を認めるかといった判断に集中しやすくなる。
ここでは「受け付けた」「実行中」「完了」「失敗」を区別する必要がある。Grok Botのルーチンに関する公式資料でも、呼び出しのHTTP 200は受け付けて実行を始めたことを表し、仕事の完了ではないと説明されている。受付通知だけで次の工程を進めず、依頼に対応する結果と完了状態を確認する設計が必要だ。公式資料:Cursor — Routines。
実際のGrok Botの回答がDotsを起動して仕事を再開させるところまでは、まだ通して検証していない。不要なポーリングの削減や、作業時間・費用の改善は期待であり、測定した成果ではない。通知や検証にも処理が必要になるため、今後は失敗・再試行を含む一連の仕事で比較したい。
DotsとGrok Botは別サービスの作業環境を使うが、それだけで成果物が安全に分離されることや、一方が止まれば他方へ自動で切り替わることを保証するわけではない。共有するデータの範囲、受信側のアクセス権、許す操作、承認と利用上限は、連携しても引き続き管理する必要がある。
特にGrok Botでは、同じアカウント内のBotがコンピューター、ファイル、ブラウザーのログイン状態を共有する。Botごとに完全に独立した仮想PCがある、という理解は正しくない。保存にも限界があり、一時ファイル、手動で入れたパッケージ、保存していない状態に頼らず、重要な成果物は明示的に保存する必要がある。公式資料:Grok Bot — Use the computer and apps。
次の課題は、単発で確認した受信経路を実際のGrok Botの回答と結び付け、待機中の作業を適切に再開できるかを検証すること。同時に、送信者と受信者の身元、依頼と回答の対応関係を確認し、別の依頼の結果を取り込まないようにする必要がある。
同じ通知が複数回来ても、再起動を挟んでも、一つの依頼を重複実行しない仕組みも必要になる。これを永続的な冪等性として検証する。時間切れや、実行されたか分からない結果に対しては、ただ再送する前に状態を確かめられるようにする。
停止条件、実行回数の上限、返信ループの抑止も引き続き試す。さらに、届いた回答の品質を検証し、各AIに許す操作と権限を依頼の範囲に限定する。通信がつながることだけでは、安全に仕事を任せられる根拠にはならない。
使用したのは害のないダミーデータである。この記録は一般化した実験結果だけを扱い、企業・顧客の情報や非公開のデータは含めていない。
一往復の成功は、次の検証へ進むための足場になった。ただし、業務・企業向けの本番運用に耐えることや、AIが自律的に権限を広げて判断・実行してよいことを示す成果ではない。まずは小さな依頼を、対応関係と止め方が分かる状態で、確実に往復させる。その続きを観測していく。
UNREALM名義のLINE絵文字「ケドゥシャー!セラフィムちゃん!」、26個の審査申請まで進みました。今回は、その制作と申請の進め方を記録します。
今回、私が自分で画面を操作したのは、認証と口座登録だけです。それ以外の制作・調整・登録・申請に必要な操作はAIに任せました。私は会話を通じてデザインの方向性を伝え、出来上がったものを確認し、修正をお願いしました。デザインや申請へ進むことは、私が決めています。
出発点は参考画像と、どんな絵文字にしたいかという方向性です。そこから画像を調整し、LINE絵文字として登録するためのファイルを用意しました。画像の整形にはPythonを使い、絵文字本体は180×180ピクセルのPNG、タブ画像は96×74ピクセルに。こうした寸法に合わせる作業も、私が画像編集ソフトを操作するのではなく、会話で依頼して進めています。
画像がそろったら、プレビューを見ながら確認しました。制作途中には、005の表情を修正しています。それとは別に、笑顔や閉じ目の線が口のように見えることにも気づきました。そこで、目だと分かるように、まつ毛を3本加えました。
この確認では、単に画像ができているかだけでなく、見た人に意図した表情として伝わるかを見ています。ファイルの寸法を整える作業と、表情の見え方を判断する作業は、それぞれ別に必要でした。気になった箇所を言葉で伝え、修正後の見え方を確認する、というやり取りを重ねています。
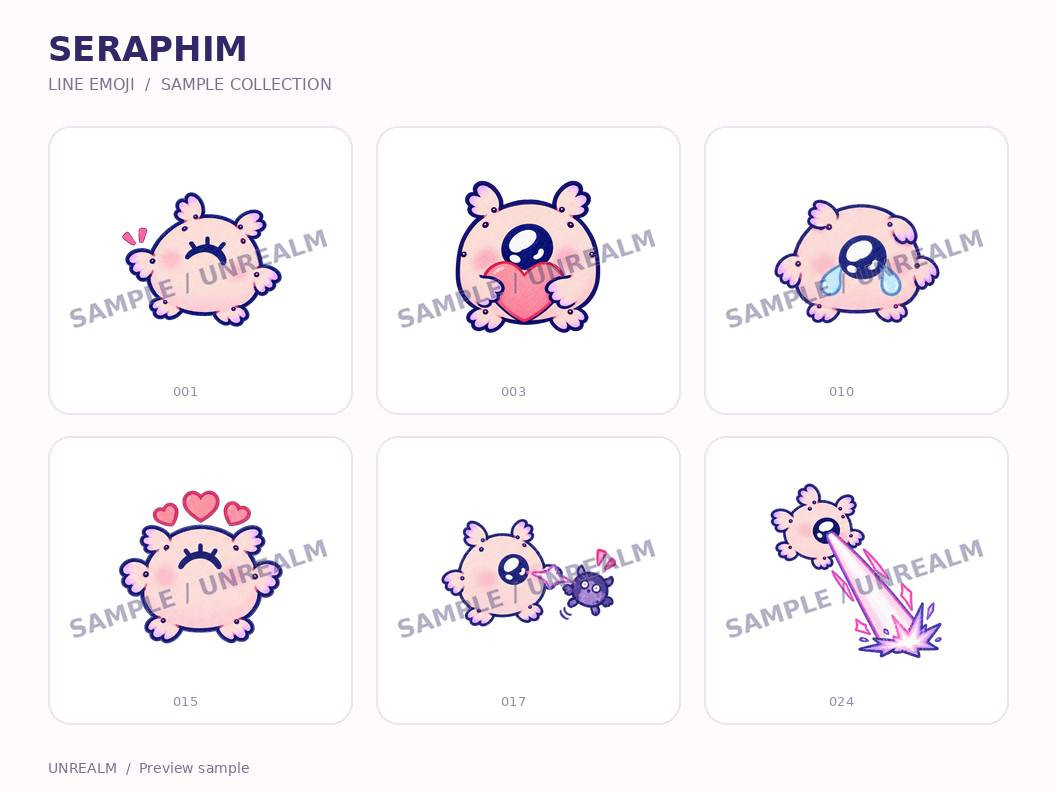
調整した画像を確認し、登録から申請へ。2026年10月12日14時59分、日本時間で審査申請が完了しました。その時点では審査待ちです。この日誌は申請までの記録で、審査通過や販売開始を報告するものではありません。
今回の流れを並べると、参考画像と方向性の共有、画像調整、Pythonによる提出用ファイルの準備、プレビュー確認、登録、審査申請となります。操作の大部分をAIに任せながら、作品の方向性や修正の要否、申請へ進む承認は、私が会話の中で担いました。
「認証と口座登録以外、画面を操作していない」というのが、今回の実践で記録しておきたい点です。制作への関わり方が、画面上で一つずつ作業する形から、伝える・見る・決めるという会話中心の形になりました。セラフィムちゃんの絵文字は、その進め方で申請までたどり着いた制作例です。
当時の構成メモでは、Windows上の仮想オーディオ経路を二つに分けていた。仮想オーディオは、アプリが出す音を別のアプリの入力へ渡すための仕組みだ。
会議側からAIへは、Teamsの音を一方の経路に流し、ChatGPTの音声入力へ渡す。反対側は、ChatGPTが返した音をもう一方の経路に流し、Teamsの音声入力へ渡す。
行きと帰りを分けることで、どの音をどこへ送っているのかを整理しやすくする。この実験では、音が届くことに加えて、自分の返した音を再び拾い続けないかも確認対象にした。
ここに書いたのは当時の接続の考え方だ。現在の各アプリにそのまま使える設定手順としては検証していない。
8月23日の利用者側の報告では、双方向に2往復の会話が成立し、音声ループは発生しなかった。片側の音を聞くだけでなく、返事が反対側へ戻るところまで試した記録になる。
この試験ではOpenAI APIを使わず、契約していたChatGPTの画面と音声モードを使った、と記録している。API経由の音声システムを新たに構築した事例ではない。
ただし、これは当時使った構成についての説明だ。現在のプランの利用条件、利用枠、継続稼働の可否や、他の人の環境でも同じ結果になることを示すものではない。
音の接続ができても、会議に参加する仕組みとしては確認することが残る。
当時の整理では、会議への自動参加、発言の自動制御、ほかの業務システムとの連携は未実装だった。音声経路の試験と、その先の自動化は分けて扱っている。
会話を二つの側で文字に残して照合することや、長い時間つないだまま動かす試験も、次の確認項目として挙げていた。今回参照できた記録からは、それらが完了したとは言えない。
また、2往復で音声ループがなかったという結果だけでは、長時間の安定性、複数人が同時に話す場面、接続が切れた後の復帰まで確かめたことにはならない。
この音声接続の先に考えているのは、自分の背景や、これまでに話した条件を共有したAIと、会議の中でも一緒に考える使い方だ。たとえば要件定義なら、過去に決めたことや残っている疑問を手がかりに、その場の相談を具体化する助けになる可能性がある。
会議ごとに前提を説明し直す負担を減らし、新しく決まったことを次の相談へつなげられれば、継続した話し合いに役立つ。音声で話せることに加えて、どの背景情報を渡し、どの合意を残すかが重要になる。
ただし、今回紹介した実験で確認したのは、音声が双方向に届いたという当時の報告まで。背景情報の蓄積、会議内容との統合、要件の保存や次回への引き継ぎを、一つの仕組みとして実証したわけではない。これらは業務での活用像として分けて記している。
接続の準備を人が行う形でも、この使い方を検討する出発点にはなる。会議への参加から記録までをすべて自動化できることを前提にはしない。実際に使うには、共有してよい情報、記録する内容、最後に人が確認する範囲を決める必要がある。
この記事は、2026年8月23日の会話上の報告と構成メモをもとに、2026年10月9日にまとめた回顧記録だ。元の録音、計測ログ、実装コードを今回再確認したものではないため、観測結果は当時の報告として記している。
TeamsやChatGPTに標準で備わる会議参加機能の紹介でも、現在使っている音声アシスタントがそのままTeamsへ参加できるという案内でもない。二つのアプリの音をつないだ個別の実験として扱う。
実際の会議で使う場合は、参加者への説明と同意、所属先のルール、音声を外部サービスへ渡してよいかの確認が必要になる。この記事には、会議の内容や参加者の情報は含めていない。
今回残しておきたいのは、まず短い会話を双方向に通せたという報告と、まだ確かめていない範囲の区切りだ。音がつながった先にある運用の課題も、一緒に記録しておく。
Teamsで話す人の声をAIに届けて、AIの返事をTeams側へ戻せるだろうか。以前、その音の通り道をつくる実験をした。
イメージとしては、パソコンの中に二本の音声ケーブルを用意する。一方で会議側の声をAIへ送り、もう一方でAIの声を会議側へ返す。マイクとスピーカーを近づけて音を拾わせる代わりに、音を別のアプリへ渡す仕組みを使う。
2026年8月23日の会話に残した報告では、TeamsとChatGPTの音声モードをつなぎ、双方向に2往復の会話ができた。その試験中、返した音が再び入力に戻って繰り返される、音声のループは起きなかったとしている。
短い会話が往復したところまでが、この記録の中心だ。予定の時刻にAIが自分で会議へ入り、必要な場面を判断して発言するところまで完成した、という話ではない。
今回は、その過去の試験を振り返って整理する。新しい会議への接続や、現在の環境での再試験は行っていない。
ネットの安全性に関する話を見かけたことをきっかけに、UNREALMのサイトと、AIに仕事を頼むための仕組みを点検した。
まずは設定やプログラムを読むところから始めた。調べる中で、AIに任せる範囲を区切る部分に、気になる点が二つ見つかった。
一つ目は、「この棚の中だけで探してね」と頼んだのに、棚の外まで探せてしまうような問題。読むだけの作業でも、見てよい範囲を守る必要がある。二つ目は、「この仕事は進めていいよ」という許可を、別の仕事や、内容が変わった仕事にも使えてしまう問題だった。
実際の仕事や大切な情報を使わず、仮のデータで試すと、どちらの問題も確かめられた。そこで、元の仕組みをコピーして、必要な部分だけを直した。困った動きが止まるか、普段の動きが壊れていないかを試してから、承認した二つのファイルだけを元の環境へ反映した。戻せるように元のファイルを残し、反映後も試験した。
今回、実際に侵入されたり、情報が漏れたりした事実を確認したわけではない。また、試験に通っても「これでもう絶対に安全」とは言えない。修正後の仕組みで、実際の仕事を最初から最後まで動かす確認はまだ行っていない。
見つかった問題を、小さく直して、確かめた範囲を残す。今回はそこまで進めた。ここから先は、その詳しい記録になる。
10月8日、DNSに関する実証コードの話をきっかけに、UNREALMと個人用のAI Agent基盤を点検した。DNSは、ドメイン名から接続先を調べるための仕組みだ。実証コードは、ある条件で問題が起きることを示すための小さなプログラムを指す。
今回は、その実証コードの主張全体を検証したわけではない。自分の環境について、外から確認できる設定と、手元のプログラムで確かめられる範囲を分けて調べた。
最初は設定やファイルを読むだけにした。問題の候補が見つかってから、実際の仕事に使わない試験用データで再現し、別のコピーで修正を試した。最後に、承認した範囲のファイルだけを元の環境へ反映した。
この記事は、その順序と、確認できた範囲の記録になる。
調査時点のUNREALMの公開応答では、DNSの情報を管理するネームサーバーはムームーDNSのdns01、dns02だった。XServerのネームサーバーではなかった。ドメインの登録先、DNSの管理先、サイトの配信先は、それぞれ分けて確かめる必要がある。
GoogleとCloudflareの公開DNSで照合すると、unrealm.xyzの接続先IPv4アドレスは162.159.143.30と172.66.3.26で一致していた。
DNSの応答を署名で検証する仕組み、DNSSECに関わるDSとDNSKEYは、今回の照会では観測できなかった。ただし、これだけで乗っ取りや侵害が起きたとは言えない。
公開DNSから見えるのは、問い合わせた時点の応答だ。管理画面の変更履歴や、管理している設定全体まで確認できたわけではない。特定の事業者の問題とも、今回見かけた実証コードがこの環境に当てはまるとも断定しない。
個人用のAI Agent基盤では、情報を探して読む処理と、承認された依頼を扱う処理を調べた。
読み取り専用なら、書き換えによる影響は抑えられる。それでも、許可した範囲の外まで読めてしまわないかは、別に確認する必要がある。今回の点検では、検索する場所の境界を守る処理に問題が見つかった。
もう一つは、承認と依頼の対応だった。ある依頼を承認したことが、別の依頼や変更後の内容にも使い回されてしまわないか。こちらにも修正が必要な箇所があった。
いずれも、用意した仮のデータと隔離した試験環境で問題を再現した。実際の利用中に情報が漏れた、承認していない仕事が実行された、という事実を確認したわけではない。
修正は別のコピーで行った。検索できる範囲を確認する処理と、承認をその依頼に対応させる処理を見直し、通常の動作と問題が起きる条件を試した。
Windows側の隔離試験では127項目が合格し、1項目を対象外として記録した。除外した項目まで合格に数えてはいない。
さらに、Windows上でLinux環境を使うWSLでも、仮のデータを使った11ケースを確認した。こちらは別の試験結果として扱う。127と11を足して「重複のない138項目に合格した」とはしていない。
WindowsとWSLでは同じデータが違う場所のように見えることがある。今回使った試験用データも、両側から同じ実体を参照していることを確かめた。表示上の場所が違うことと、独立した環境で確かめたことは区別したい。
コピーでの検証後、承認した2ファイルだけを元の環境へ反映した。反映前の2ファイルはバックアップし、戻せる内容であることを確認した。
反映したファイルが、試験に使った修正版と一致することを確認し、構文のチェックも行った。反映後も実際の仕事から切り離した試験を実施し、127項目の合格と1項目の対象外を確認した。確認対象の残り42ファイルに変更はなかった。
ここで完了したのは、検証済みの小さな修正を反映し、反映結果を確かめるところまで。稼働中の実行担当やジョブを起動・再起動・停止する操作はしていない。実際の仕事を最初から最後まで流す動作確認も、今回の結果には含めない。
また、同時に別の処理がデータを書き換える場合など、共通の制御に従わない書き込みに対する制約は残っている。今回の試験結果を、そのままシステム全体の安全保証にはできない。
公開情報を読む。問題の候補を見つける。仮の環境で再現する。コピーで直す。反映する範囲を承認する。反映後にもう一度確かめる。
一つの「対応済み」という言葉でまとめると、どの段階まで進んだのかが見えにくい。今回は、観測した事実、試験で確かめたこと、実行を許可した範囲を分けて記録した。
AIに任せる作業でも、読む範囲と動かす範囲は具体的にしておきたい。試験の合格数に加えて、対象外にしたこと、実際の環境ではまだ確かめていないことも残す。その記録があれば、次に確認する範囲を決めやすくなる。
今回の着地点は、見つかった2点への修正と、限定した範囲への反映確認だ。未確認の部分まで「安全になった」と広げず、ここまでの結果として残しておく。
記録日:2026年10月8日。DNSの記述は調査時点の観測であり、設定は今後変わる可能性がある。
公開DNSの照会先:Google Public DNS。unrealm.xyzのNSレコードを照会した。以下は再照会用のURLで、当日の応答を固定した記録ではない。
https://dns.google/resolve?name=unrealm.xyz&type=NS&do=true
Agent基盤の修正については、手元の隔離試験と反映確認に基づいている。内部の構成、コード、再現手順、個人情報はこの記事には含めていない。
「進められるところまでやって、朝6時半にまとめておいて」
最近、こんな頼み方でAIに仕事を任せてみた。
AIというと、質問を入力すると答えが返ってくるもの、というイメージがあるかもしれない。ChatGPTも、言葉で質問や相談ができるAIだ。
自分は今、DotsというAIアシスタントを使っている。秘書や、一緒に仕事を進める相手のように使いたいと思っている。
メール、予定、作りかけのもの。「あとでやろう」と思ったまま忘れたり、途中で止まったりする仕事を減らせるか。それを試している。
まだ試している途中なので、ここで書くのは途中経過だ。実際に進んだことと、残ったことを整理してみたい。
こちらで手順を細かく決めすぎると、AIに任せられることまで減らしてしまうのではないか。使い始めて、そんなことが気になった。
そこで10月3日から10日までの一週間、以前から使っていた独自の仕組みを持ち込まずに試すことにした。この記事を書いている10月6日は、その途中だ。
調べ物や下書き、やり直せる範囲での試作は任せる。一方、誰かにメールを送る、記事を公開する、契約するといったことは、先に自分が確認する。
何でも任せるというより、どこまで進めてよいかを決めておく感じだ。
ただし、細かい指示を減らしたおかげで能力が上がった、とまでは言えない。同じ条件で比べたわけではないので、今はこの頼み方で何が起きるかを見ている。
寝る前に頼んだのは、パソコンの安全確認に関わるソフトの試作だった。「ある程度作って」「進められるところまで」と伝えておいた。
朝の報告には、試作品と、仮のデータを使った動作確認の結果があった。一つひとつの操作を自分が指示しなくても、作業が進んでいた。
ただ、これで完成というわけではない。
既存のソフトに組み込む作業はできていなかった。必要な元のプログラムが見つからなかったためだ。実際の情報を集める段階でもアクセスが許可されず、確認できていない部分が残った。
その後は、警告が出たら原因を調べ、集めた証拠と結果を返す流れを試している。こちらも、まだ仮の環境での確認だ。
動作確認の項目が増えても、本当に役立つかどうかは別に確かめる必要がある。実際の異常を見つけられた証拠にもならない。
「何を作ったか」と「どこまで確かめたか」。朝の報告では、この二つを分けて読むことが大事だと思った。
接続先のパソコンがオフラインになり、作業が止まったこともあった。再び接続できるようになってから、続きを進めている。任せた仕事でも、必要なパソコンにつながらなければ止まる。
人物イラストも試した。画像はできたものの、指定した顔の比率を十分には再現できていなかった。画像ができることと、自分が求めたものになることには差がある。ここは人が見て判断する必要があった。
調べ物では、車の前照灯に関する規定を追った。「今の扱いを裏づける資料」と「歴史上、最初に認められた日」は、別の問いとして整理している。
答えが出てきたときも、その答えでどこまで言えるのかは確認したい。
ここまで試して、頼むときに何を共有しておきたいかが見えてきた。
何を達成したいのか。
何ができれば終わりなのか。
どこから先は自分に確認してほしいのか。
いつ報告してほしいのか。
例えば「作っておいて」だけでは、試作品ができればよいのか、普段の環境で使えるところまで必要なのかが曖昧になる。
途中まで進めてほしいなら、できたことに加えて、残ったことが分かる報告も大切になる。
まだ一週間の途中だ。これから見たいのは、止まっていた仕事が本当に進むか、確認の手間や手戻りがどう変わるか、最後に実際の環境でも確かめられるか。
細かな手順を渡すだけでなく、ゴールを伝えて任せる。その使い方が日々の仕事でどこまで成り立つのか、引き続き試している。
9月26日から10月2日は、AI同士の作業配送への追加実装より、ChatGPTから状況を参照する入口の検証を中心に進めた。SitesでホストしたMCPサーバーをプラグインとして呼び出し、読み取り専用で情報を取得できるかを確かめた。
総合判断は部分合格。観測経路は通ったが、ローカルの開発環境とのライブ同期は行っていない。GrokBotの追加連携は意図的に保留している。
非公開Site、ホストされたMCPサーバー、プラグイン、ChatGPTという接続経路は通過した。読み取り専用の4ツールと、通常のChatGPTで行った3試験で、期待どおりの結果を確認した。
この接続試験は完了し、手動検証済みとして記録した。ただし自動更新は無効。ほかの開発案件の状況として表示している情報はダミーで、実際の進捗監視や判断の根拠には使えない。今回確認した範囲は、用意したデータをChatGPTから参照できることまで。
GrokBotの追加連携と、外部からの通知を受け取るWebhookの導入は、10月1日に意図的な保留へ変更した。導入完了という意味ではなく、再開を希望するまで停止する方針としている。
週次レビューのGitHub確認では、対象期間中の作業配送用リポジトリのコミット、プルリクエスト、Issue更新、自動実行はいずれも0件。最終の送信は9月21日のままだった。観測入口の検証と、配送本体の進捗を混同しないように記録する。
調査が300秒で時間切れになった際の途中結果の保存と、矛盾する情報を扱う異常系について、新たな修正・再試験の証跡はない。
完了済みの作業3件は、GitHub上ではIssueが開いたまま。完了した作業を再取得して重複配送しないことも、まだ実証できていない。
ローカルの読み取り口は、再確認時に429、続いて404となり、今週も調査結果の原本を再読できなかった。接続用トンネルの停止や期限切れは原因候補だが、原因は未確定。
まず、完了済み作業の再取得防止を試す。再起動後や複数の監視処理が動いている場合にも、完了した3件を再び引き受けず、二重配送しないことを完了条件とする。
観測入口には、実データを1案件だけ接続する検証を予定する。GitHubの公開して差し支えないメタデータだけを自動取得し、出典、更新時刻、情報が古くなったことを表示できるかを見る。ローカルファイルや個人ナレッジへの接続は、この検証には含めない。
GrokBotについては、途中結果を保存する、矛盾する根拠を保持する、誤った再試行を起こさない、という3条件を再開条件として文書化する。現時点では実行せず、保留を維持する。
今週は、状況を参照する経路を一つ検証できた。次は、取得した情報の出典と鮮度を示せるか、完了した作業を重ねて配送しないかを確かめる。
OpenAIのエージェント/Codex機能を、既存のSynedrion環境へどう組み込めるか。セキュリティ検査、クラウドでの開発、イベントを起点とした連携の3方向から、小規模な概念実証(PoC)を予定している。本記録は着手前の計画であり、実装結果や検証結果はまだない。
既存環境には、AI間のメッセージ配送を担うagmsg、MCPサーバー、Secure MCP Tunnelがある。今回はこの構成を出発点として、追加する機能の役割と境界を整理する。
セキュリティ上の見落としを補えるか。開発作業の一部をクラウドへ分け、ローカルPCの負荷を減らせるか。ローカルで起きた変化をきっかけに、必要なAI処理を呼び出せるか。いずれも現時点では仮説で、効果や採用を前提にしない。
Codex Security:GitHub上のSynedrion関連リポジトリを対象に、攻撃経路や守るべき境界を整理する「脅威モデル」、脆弱性の検出、誤検出の傾向、修正提案の品質を確認する。既存のセキュリティ検査との役割分担も見る。最初は読み取り専用の確認と提案のレビューに限定し、自動修正やマージは行わない。
Codex Cloud Environment:小規模なリポジトリで、ビルドとテストをクラウド上でも再現できるか試す。環境の再利用、構築の手間と費用、ローカルPCの負荷、Windows固有の依存を記録し、ローカルとクラウドの担当範囲を考える。まず一部の作業を動かすPoCから始める。
MCP Events:既存の配送や接続を維持したまま、ローカルの出来事をagmsgからMCPのイベントとして渡し、ChatGPT/Dotが受け取り、必要に応じてCodexやMCPの処理を呼ぶ経路を構想している。まず構成と権限の境界を整理し、利用条件を確認したうえで最小構成のPoCへ進む。この経路はまだ成立を確認していない。
各機能を手元の契約・権限で利用できるか、接続に必要な条件、費用、既存環境との互換性は、実験開始時点の公式情報で確認する。特にMCP Eventsは、対象となる機能・仕様とChatGPT/Dotでの受信方法を未確認としている。
セキュリティ検査の精度、クラウドでの再現性と負荷削減、イベント配送の遅延・欠落・重複、どこで人間の確認を挟むべきかも、これからの検証対象となる。
セキュリティ、クラウド実行環境、イベントを起点に動くエージェントの3方向から、Synedrionの次のアーキテクチャを検証する。
自動車業界には、確認先が見つけづらく、地域や工程によって扱いが異なる決まりがある。こうした情報を継続的に集め、出典を確認してナレッジに蓄積する仕組みを構想している。今回確かめたのは、その一部となる「調査結果を集めて次の担当へ渡す」経路だ。
9月19日から25日にかけて、GrokBotで追加の調査費用を抑えながら情報を集められるか、CCR(ChatGPTとローカル環境をつなぐ仕組み)を通じて検証担当へ引き渡せるかを試した。あわせて、JevをAIの文脈整理に使えるかも評価した。
今回は「情報が届いたこと」と「情報が正しいこと」を分けて扱う。調査担当が集めた内容は未検証のまま渡し、次の担当が一次情報と照合する。
GrokBotが情報収集を担い、検証を別の担当へ渡すことで、調査のたびに高い費用のかかるAIへ長い検索結果を読ませずに済むかを試した。実行記録にはウェブ検索9回、発見事項9件、根拠資料21件が残った。収集して引き渡す経路は通った。ただし今回の収集内容だけで、地域差や工程ごとの例外を十分に網羅できたとは判断していない。
一方、この記録だけでは実際の利用料金、ほかの方法と比べた総費用、失敗時の再試行費用は判断できない。「無料で収集できた」「従来より安くなった」とはまだ結論づけない。300秒で時間切れとなる例もあり、使い続ける費用を考えるには、成功率と再試行回数も測る必要がある。
ローカルの実装担当であるCodexに読み取り専用の作業を渡す試験では、作業番号、追跡番号、実行上の制約、結果のコメントを非公開のGitHub Issueで往復できた。次に、GrokBotの調査結果をCCR経由で引き渡し、後続の検証担当が確認する経路も通過した。
結果の形式確認も通過した。GrokBotの出力は「未検証」と明示して引き継いだ。件数や形式の合格は、発見事項の正しさを証明するものではない。
優先度の高い根拠11件を公式の一次情報で再確認し、9件を後続の資料へ反映したとの作業報告もある。関連するデータ確認17件、統合確認10件、自動テスト22件は通過したとの報告。ただし今回の週次確認では、ローカルの元記録へ再接続できず、この反映部分を独立には再検証できていない。
Jevは調査そのものではなく、AIへ渡す文脈から重要情報を守りつつ量を減らす判断に使えるかを試した。安全上の条件に従って途中で停止し、120件を予定したうち2件の段階で終了。入力トークンの削減は0%だった。本番の連携も無効のままとし、現方式は採用しないと決めた。
削減効果が出ないまま採用へ進めず、停止条件を実行できたことも今回の確認結果に含める。
長時間の調査が300秒で時間切れになった場合、途中までの結果を確実に保存できるかは未確認。互いに矛盾する根拠を保持して検証担当まで届ける自動の経路も、まだ実証できていない。複雑な矛盾の判断は現時点ではAIまたは人間へ引き継ぐ。
また、完了済みのIssueがGitHub上では開いたままになっている。本文で完了と分かっていても、監視処理が再取得して二重実行しないかを、複数の監視担当や再起動を含めて確かめる必要がある。
今週の証跡はIssueとローカル試験が中心で、プルリクエストや自動実行の実績はない。週次確認時にはローカルの読み取り口へ接続できなかったため、GitHubに残る要約とローカルの原本を突き合わせる作業も残った。
まず強制的な時間切れでも途中結果を保存し、矛盾する根拠を消さずに引き渡し、再試行で二重に実行されないことを確認する。次に、完了済みのIssueを複数の監視担当や再起動後も再び取得しないかを試す。
原本に接続できない日でも、結果の形式、件数、内容の照合値、テストの要約だけは確認できるよう、秘密やローカルの実際の保存先を含まない短い証跡を残す方法も検討する。
次の調査では、検索回数に加えて実行時間、失敗・再試行回数、実際の利用料金を同じ単位で記録し、既存の調査方法と比べる。
今週の判断は「GrokBotによる調査結果を検証担当へ渡す経路は通った。Jevによる今回の文脈保持方式は採用しない」。自動車分野の知識を継続して蓄積できるか、低コストで運用できるか、時間切れ・矛盾・二重実行に耐えられるかは未確定。次の計測と異常系試験で判断する。
AIエージェントが繰り返す小さな判断をJevに任せることで、処理時間や費用を減らせるのではないか。
画面操作の次の一手、使用するAIの振り分け、AIへ渡す情報の選別を順に試した。情報の選別で回答品質が低下したため、その後は重要情報の保持も検証した。
Codexの画面操作機能で操作候補を取り出し、Jevが次の操作を選び、Codexが実行する構成を試した。
実際のAPIを使った評価は15件中15件成功し、誤操作は0件だった。この範囲では操作の安全性や成功率に問題は見られなかった。
一方、所要時間は通常の画面操作に対して約2倍前後となった。もともと数秒で終わる判断に外部APIへの問い合わせを追加したため、通信と判断の待ち時間が速度上の利点を上回ったと考えられる。
画面操作の高速化には採用しないと判断した。
作業内容を「軽い実行処理」「標準的な推論」「高度な推論」「人間による確認」の4種類へ振り分ける用途を評価した。
| 指標 | Jev | 固定ルールのプログラム | |---|---:|---:| | 人工的に作成した課題の正答数 | 240 / 240件 | 240 / 240件 | | 処理時間 | 中央値 約269ms | マイクロ秒単位 |
同じルールを通常のプログラムで実装した比較対象も全件正答した。今回の課題では品質差がなく、外部の判断モデルを使う利点は確認できなかった。この用途も採用を見送った。
検索やエージェントの実行で集まった参考情報から、必要なものだけをJevで選ぶ方式を試した。ここで大きな削減効果が出た。
| 指標 | 人工データによる初期評価 | 最終回答まで生成した比較評価 | |---|---:|---:| | 参考情報の候補数の削減率 | 約70% | 約81% | | 入力トークンの削減率 | 推計 約65% | 実測 約54.5% | | 必須と指定した情報の保持 | 100% | 欠落0件 | | Jevの処理時間 | — | 約300ms |
トークンは、AIが文章を処理する際の量を表す単位。初期評価の削減率は推計であり、その後に実際の回答生成まで通して入力トークン数を測定した。
ただし、100件の回答比較で5件に重大な品質低下が生じた。必要な事実自体は残っていても、出典や周辺情報とのつながりが落ち、最終回答に必要な関係を保てなかった。
参考情報には、事実、出典、制約、反証、重複情報、指示など、それぞれ異なる役割がある。「必須情報を残せた」という指標だけでは、回答品質を保証できなかった。
入力は大きく減らせたが、この選別方式は採用しないと判断した。
次に、必ず残すべき情報を判定する方式を試した。各候補について、意味の重要性、原文のまま残す必要性、出典、矛盾、指示、後から再取得できるか、情報が古くなっていないかを判定した。
会話や資料を要約・圧縮した際に重要情報が落ちた場合だけ、元の情報を補い直す構成にした。
情報の保持を優先できた一方、判断が不確かな候補をすべて残した結果、評価したケースでは最終的なトークン削減率が0%となった。今回の方式では、品質を守りながら入力を減らす効果は得られず、採用を見送った。
| 用途 | 観測結果 | 判断 |
|---|---|---|
| 画面操作の次の一手 | 15 / 15件成功、所要時間は約2倍前後 | 高速化用途では不採用 |
| 使用するAIの振り分け | 固定ルールと同じ正答率、処理は遅い | 不採用 |
| 参考情報の選別 | 入力を約54.5%削減、100件中5件で重大な品質低下 | 現方式は不採用 |
| 重要情報の保持 | 不確かな候補も保持し、削減率0% | 現方式は不採用 |
今回試した範囲では、JevをAIエージェントの汎用的な高速化手段として採用する根拠は得られなかった。一方、参考情報の選別には実測で50%以上の入力削減が見られた。ただし品質低下を伴っており、そのまま使える成果ではない。 次の論点は、Jevに任せる判断の範囲をどこまで狭めるかにある。広い文脈をまとめて削る方式より、対象と判定基準を限定した分類や採点が適する可能性はあるが、これは今後の仮説とする。
同じ実験の中で、Gitを介してAI同士が結果を受け渡す運用も試した。
ローカル側のAIが実験結果を非公開のGit保管先に記録し、人間は「Gitを更新した」とだけ伝える。レビューを担当するAIがその記録を直接読み、次の判断を行う。
この運用では、長い実験ログや背景説明を人間がAI間でコピー&ペーストする作業をほぼ省けた。今回、成立を確認できた協業方法として残す。
出典や制約などの重要な付帯情報は固定ルールで常に保持し、Jevには「重複している」「古くなっている」「後から再取得できる」本文だけを判定させる構成を候補とする。
ほかに、引用・出典の不足確認、範囲を限定した情報抽出、ツールが返した結果の検証も候補になる。いずれも今回の採用判断とは分け、未検証として扱う。
次回は入力の削減率に加え、出典や情報同士の関係が最終回答まで維持されるかを確認する。品質が低下した場合は元の構成へ戻す。
ChatGPTとローカル開発環境を、人間のコピー&ペーストに依存せず接続できるか検証した。
今回は、指示や結果の要約を運ぶControl Planeと、必要なローカル情報を取得するData Planeを分離した。公開範囲は接続方式と観測結果に限定し、基盤全体の構成は扱わない。
ChatGPT
├─ Control Plane → GitHub → Local Relay → Local Agent
└─ Data Plane    → Secure MCP → Local Gateway → Files / Git
Control Planeは小さなtask、state、result summaryを扱う。Data Planeはファイルをクラウドへ複製せず、必要な箇所だけをローカル環境から検索・部分取得する。
Data Planeの初期toolをsearch_files、read_file、git_statusの3つに限定した。MCPはread-only、deny-winsを基本とし、binary、secret-like content、path traversal、任意commandを拒否する。
一度に全経路を接続せず、Control PlaneとData Planeを分けて確認した。Tunnel credentialは短期かつ最小権限で使用し、検証後に停止した。
| 観測項目 | 結果 |
|---|---|
| ファイル検索 | PASS |
| 部分読込 | PASS |
| Git状態取得 | PASS |
| read-only確認 | PASS |
| 回帰test | 79件 PASS |
Secure MCP Tunnel経由でsearch、partial read、git statusまでの実E2Eが通過した。ローカルファイル本文を事前にクラウドへ配置せず、必要な情報だけを取得できた。
Private repositoryは初回接続時に404となり、接続対象の許可範囲を見直した。Windows側ではCLI導入にも追加作業が発生した。
また、read-only toolがChatGPT側でdestructive、open-worldとして分類された。実装上の権限ではなくMCP tool annotationとの不一致が原因で、readOnlyHint、destructiveHint、openWorldHint、idempotentHintを実態に合わせて修正したところ解消した。
ChatGPTからローカルのFiles / Gitへ到達するData Planeは、限定したread-only範囲で成立した。Control Planeと分離したことで、配送経路と参照経路を個別に切り分けられる状態になった。
これは接続成立の確認であり、ローカル情報全体を安全に公開できることを意味しない。公開範囲、deny rule、取得量は引き続き個別に管理する。
次はResearch Planeを分離し、Local Context、External Research、Local Implementationを独立した経路として扱えるか検証する。
ルール文書の読込が複数箇所へ分散すると、追加のツール呼出とコンテキスト再投入が発生し、トークン消費が増加する。
READMEの軽微なtypo修正を対象に、rule read fan-outだけを分離した隔離条件でBaselineとExperimentalを比較した。
| 指標 | Baseline | Experimental | 変化 |
|---|---|---|---|
| ルール読込 | 6回 | 1回 | -83.3% |
| ツール呼出 | 10回 | 5回 | -50.0% |
| 入力トークン | 163,457 | 113,601 | -30.50% |
| 合計トークン | 164,760 | 114,294 | -30.63% |
| 所要時間 | 112.7秒 | 74.7秒 | -33.7% |
品質と安全性の低下は、この隔離runでは確認されなかった。
rule read fan-outが主要なtoken cost driverである可能性は支持された。ただし観測は隔離環境における1回のみであり、一般的な改善効果とは判断しない。
cache条件やtask categoryによる影響は未確定。結果を他のタスクへ一般化しない。
自然発生する通常タスクを対象にtelemetryを蓄積し、cache条件とtask categoryを分離して再評価する。
ネットワークの不調を、観察できる問題に。
Windows向けのローカルネットワーク監視・調査ツール。
ネットワークの不調は、確認しようとした頃には解消していることがあります。いつ、どこへの接続が不安定だったのか。調査の出発点になる記録を残します。
localhost DashboardでNIC、ゲートウェイ、端末、接続統計、アラート、履歴を確認できます。信頼できるプライベートLAN向けのLAN ModeではViewer/Admin、任意のAdmin TOTP、Recovery Codes、QRアクセスを利用できます。
SHA-256
F795FCCA014A53FA3FE710D886A9159B5B157A50AC7618966298961B5E0E6D14企画、要件定義、設計、AI Agentとの協業実装、自動test、security hardening、packaging、Installer、Release Managementまでを一貫して構築しました。
Public v1は275件の回帰testを通過。配布repositoryではRelease履歴、変更履歴、Manual、License、Privacy、Security情報を管理しています。